AI
RAGと
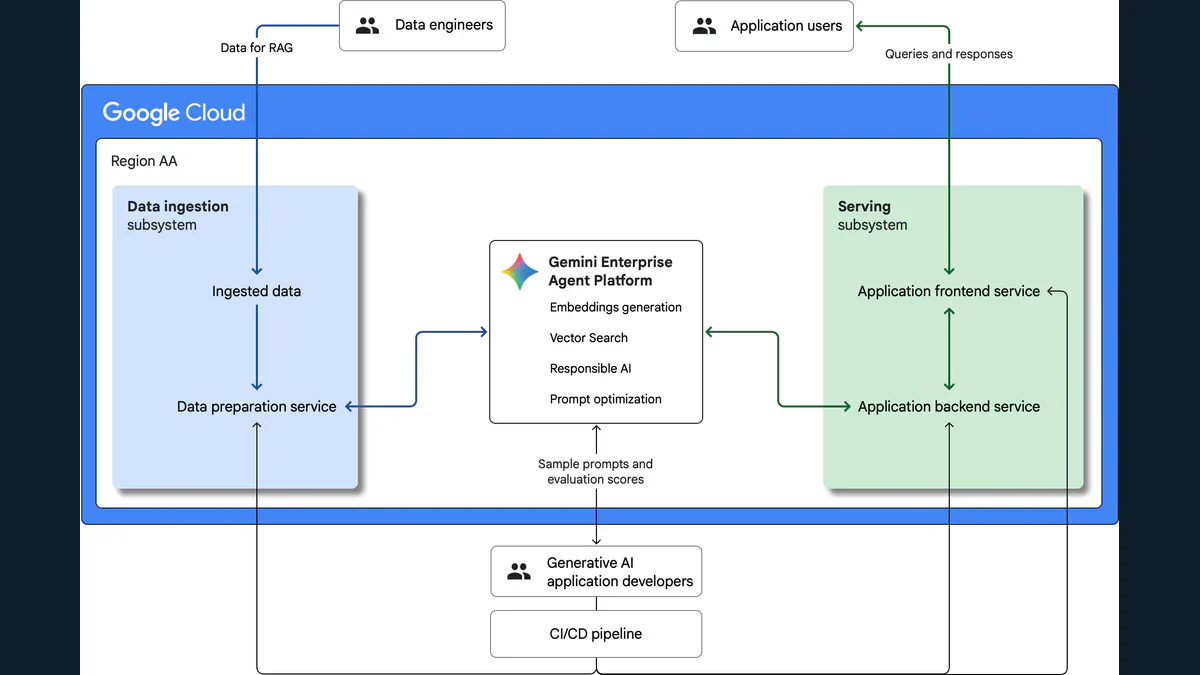
画像出典: RAG infrastructure for generative AI using Agent Platform and Vector Search
RAGとロングコンテキストの違いを、精度、費用、更新性、権限管理、導入負荷から比較します。固定資料なら全文入力、大量で頻繁に変わる情報ならRAGが有力です。社内文書の検索や要約に生成AIを使いたい事業責任者向けに、併用を含む選定手順を解説します。
はじめに
RAGとロングコンテキストのどちらを選ぶかは、資料の量だけでは決まりません。 少数の固定資料を要約または比較するならロングコンテキスト、大量の文書や頻繁に更新される文書から必要な情報を探すならRAGが有力です。
社内規程や商品資料を生成AIに読ませる場合、事業責任者は技術を選ぶ前に「どの資料を、誰が、何の判断に使うのか」を決めます。 この条件が曖昧なまま方式を決めると、検索精度の調整に費用をかけても利用が増えなかったり、全文を毎回入力して費用と待ち時間が増えたりします。
したがって、対象資料の量と更新頻度に加え、利用回数、権限管理、回答根拠の示し方も確認します。 これらの条件をそろえなければ、RAGとロングコンテキストの優劣は比較できません。
RAGと
RAGとロングコンテキストの違いは、生成AIへ資料を渡す前に、質問と関係する箇所を絞るかどうかです。 RAGは関連箇所を検索してから渡し、ロングコンテキストは対象資料を広くまとめて渡します。
文書を検索できる状態で保管し、質問ごとに関連部分を取り出して回答に使う方式を、RAG(検索拡張生成)と呼びます。 原型となった研究では、研究者が生成モデルと検索可能な外部知識を組み合わせ、知識の更新や回答根拠の確認をしやすくする方法を検討しました。
ただし、RAGの原論文↗で扱われた構成と、現在の業務システムで使われるRAGの構成は同一ではありません。 必要な情報を検索して生成AIへ渡す点は共通しています。
一方、長い文書や複数の資料を一度にモデルへ渡す能力、またはその能力を使う方法を、ロングコンテキストと呼びます。 資料全体の要約、契約書間の比較、複数章にまたがる論点の確認では、検索時に重要箇所を取りこぼす問題を避けやすくなります。
ただし、「長い資料を入力できれば検索は不要になる」とは限りません。 Google Cloudは、長い文章の要約や質疑応答を用途に挙げる一方、複数の情報を探す条件では精度が変動すると説明しています。 Google Cloudのロングコンテキスト解説↗を踏まえると、入力可能な長さと業務で必要な正確さは、別々に評価します。
RAGと
資料全体を入力でき、十分な計算資源を使える比較実験では、ロングコンテキストが平均性能でRAGを上回りました。 ただし、この結果だけでは、自社の業務でもロングコンテキストの精度が高いとは判断できません。
EMNLP 2024で発表された比較研究では、研究者が複数の公開データセットと当時の3モデルを使い、ロングコンテキスト、RAG、質問に応じて両者を切り替える方式を評価しました。 その結果、ロングコンテキストは平均性能でRAGを上回りました。 RAGには計算費用を抑えやすい利点がありました。 RAGとロングコンテキストの比較研究↗では、質問に応じて方式を切り替える併用案も提示されています。
しかし、この研究結果は、すべての日本語業務や現在のモデルで同じ優劣を保証するものではありません。 精度は、資料の構成、質問の種類、検索設定、モデル、正解の定義によって変わります。
たとえば、就業規則から特定の条項を探す質問では、質問に関係する箇所を選ぶRAGが機能しやすいでしょう。 一方、複数の契約書を横断して条件の矛盾を探す場合は、個別検索によって関連箇所を取りこぼす可能性があります。 この場合は、対象を絞って全文を渡す方法が候補になります。
したがって、評価時には、業務で実際に使う質問と、回答に必要な資料の範囲をそろえます。 方式名だけを見ても精度は判断できません。
費用と
生成AIの利用料が安くても、業務全体の費用が下がるとは限りません。 モデル利用料だけでは、検索基盤の保守や回答の確認にかかる費用を比較できないためです。
利用回数が少ない検証では、ロングコンテキストのほうが始めやすい傾向があります。 文書量や質問回数が増えると、質問ごとに関連部分だけを渡すRAGが入力を減らしやすくなります。 一方、RAGを運用する担当者は、検索基盤を構築して保守しなければなりません。
| 判断項目 | RAG | ロングコンテキスト |
|---|---|---|
| 初期構築 | 文書分割、検索索引、評価の準備が必要 | 対象資料を入力する小規模な検証から始めやすい |
| 利用時の入力 | 関連箇所に絞れる | 長い資料を入力するほど増える |
| 継続運用 | 取り込み失敗、検索漏れ、索引更新を監視する | 入力上限、処理時間、モデル変更の影響を確認する |
| 向く利用形態 | 大量文書への反復的な問い合わせ | 限られた資料の要約、比較、調査 |
| 主な費用要因 | 検索基盤、保存、保守、モデル利用 | 入力トークン、キャッシュ、モデル利用 |
事業責任者は、月額のモデル利用料に加えて、担当者が回答を確認する時間も計算に入れます。 検索漏れが多く、担当者が毎回答えを探し直すなら、モデル利用料が安くても総費用は下がりません。 月に数回しか使わない業務のために検索基盤を作ると、保守費が削減時間を上回る可能性もあります。
比較に使う指標は、1件の正しい回答を得るための総費用です。 入力費、検索基盤費、保守時間、確認時間、誤回答の修正時間を同じ質問集で測れば、技術費と人件費を同じ条件で比較できます。
文書更新と
文書が頻繁に更新され、利用者ごとに閲覧範囲が異なる業務では、回答精度と費用だけで方式を決められません。 古い情報や閲覧権限のない情報が回答に混ざると、その回答を業務に使えないためです。
この条件では、RAGのほうが管理要件を組み込みやすい傾向があります。 運用担当者は、文書の追加や変更に合わせて検索索引を更新できます。 検索結果に文書名、更新日、該当箇所を持たせれば、利用者は回答と原資料を照合できます。
ただし、「RAGを採用すれば情報漏えいを防げる」わけではありません。 管理担当者が検索対象と権限情報を連動させなければ、閲覧を許可されていない文書が検索結果に含まれるおそれがあります。 索引の更新が遅れたり失敗したりした場合は、古い情報が検索される可能性も残ります。
Google CloudのRAG向け参照構成では、データの取り込みと回答の提供を別の処理として構成しています。 運用担当者は、索引の一括更新やストリーミング更新、アクセス制御、監査ログも検討します。 RAG基盤の参照アーキテクチャ↗は、RAGの運用に検索だけでなく、保存、更新、権限、監視が必要になる例です。
一方、ロングコンテキストでも、担当者が利用者の閲覧できる資料だけを入力すれば権限を守れます。 共有フォルダの全資料を一括で投入する運用では、入力前に資料を選別しなければなりません。
以上を踏まえ、担当者は次の条件を決めます。
- 回答に使ってよい文書と、機密度による区分
- 利用者ごとの閲覧範囲
- 文書の更新を回答へ反映する期限
- 回答に表示する文書名、更新日、該当箇所
- 根拠が見つからない場合に回答を保留する条件
- 誤回答を報告し、評価へ戻す担当者
なお、会話履歴や利用者情報を継続的に保存する用途は、社内文書を検索するRAGとは目的が異なります。 情報の保存範囲を検討する場合は、AIエージェントのメモリとRAGの違いも判断材料になります。
自社に
自社に合う方式を選ぶ際は、文書の量と更新頻度を最初の判断材料にします。 文書が少なく固定的ならロングコンテキスト、大量で頻繁に変わるならRAGを第一候補にします。 質問によって必要な資料の範囲が大きく変わる業務では、併用も候補です。
| 業務の条件 | 第一候補 | 判断理由 |
|---|---|---|
| 少数の契約書や報告書を一時的に比較する | ロングコンテキスト | 検索基盤を作らず、資料全体を照合しやすい |
| 規程、商品情報、FAQが継続的に増える | RAG | 質問ごとに必要な情報を絞り、更新を反映しやすい |
| 定型質問が多いが、複雑な調査もある | 併用 | 通常はRAGを使い、検索結果が不足する質問だけ対象資料を広げられる |
| 利用者ごとに閲覧範囲が異なる | RAGまたは入力前に選別するロングコンテキスト | 方式よりも権限の引き継ぎ方が決定要因になる |
ただし、この表だけでは最終決定できません。 同じ方式でも、資料と質問が変われば、精度、費用、確認時間も変わるためです。
最終判断では、代表的な質問と正解資料を使って小規模に比較します。 技術に詳しくない担当者も、次の手順で評価に参加できます。
- 実際の業務から、頻出質問と失敗した場合の影響が大きい質問を集める。
- 各質問の正解と根拠資料を業務担当者が決める。
- RAGとロングコンテキストへ同じ質問を出す。
- 正しさ、根拠の追跡しやすさ、回答時間、人の確認時間を記録する。
- 文書を更新し、新しい内容がいつ回答へ反映されるか確かめる。
- 利用回数を仮定し、構築費と運用費を含む総費用を比較する。
検証では、最初から全社の文書を対象にする必要はありません。 問い合わせ件数が多く、正解を定義しやすい一つの業務から試します。 その結果を使えば、売上機会、対応時間、品質、リスク低減のうち、どの項目に効果があるのかを確認できます。
まとめ
RAGとロングコンテキストの選択は、モデルが入力できる長さだけでは決まりません。 少数の固定資料を横断して読むならロングコンテキスト、大量の資料や頻繁に更新される資料から必要箇所を探すならRAGが第一候補です。 質問によって必要な資料の範囲が変わる業務では、併用も検討します。
事業責任者は代表質問と正解資料をそろえ、両方式を同じ条件で試します。 回答精度に加えて、人の確認時間、更新の反映、権限管理、根拠提示、総費用を記録すれば、自社の業務に合う方式を選べます。
参考文献
- Retrieval Augmented Generation or Long-Context LLMs? A Comprehensive Study and Hybrid Approach↗
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks↗
- Long context | Gemini Enterprise Agent Platform | Google Cloud Documentation↗
- RAG infrastructure for generative AI using Agent Platform and Vector Search↗