AI
Harness²とは?
Harness²とは、AIエージェントの指示、道具、記憶、確認手順を試行結果から改善する研究用フレームワークです。プロンプトやコンテキスト改善との違い、適した業務、期待できる効果、API費用や評価漏れの注意点、小規模検証の進め方と導入基準を解説します。
はじめに
Harness²とは、AIモデルを作り直さず、指示、道具、記憶、確認手順などの実行環境を、仕事ごとの試行結果に基づいて改善する研究用フレームワークです。 AIエージェントの導入後も成果物の抜けや確認漏れが続く場合は、AIモデル以外の設定も調べる必要があります。
AIエージェントの結果は、同じAIモデルを使っても、参照資料、利用できる道具、作業手順、最終確認の方法によって変わります。 Harness²は、こうした仕事ごとの設定を改善します。
定型外の業務をAIエージェントに任せたい事業責任者にとって、Harness²は検討対象になります。 ただし、導入の可否は精度だけでは決められません。 試行回数に応じた費用、評価方法の妥当性、情報管理も確認します。
Harness²は
AIエージェントの結果には、指示文だけでなく、制約、記憶、道具、確認手順も影響します。 Harness²では、これらをまとめた実行環境を実行ハーネスと呼び、改善の対象にしています。
実行ハーネスの改善対象は、次の8要素です。
- システム指示
- 制約
- 記憶
- 道具の使い方
- スキル
- 補助スクリプト
- 分担するエージェント
- プラグイン
たとえば、複数の表から予算案を作る業務で、数値の転記漏れが起きたとします。 担当者はAIモデルを交換する前に、入力ファイルを最初に一覧化する、出力後にファイルを開き直す、数値の出典を記録するといった作業規則を追加できます。
ただし、追加した規則が、どの業務でも同じ効果を上げるとは限りません。 Harness²は複数の候補を試し、結果の差を基に、採用する変更を組み立てます。
公式リポジトリには、8つの改善対象、対応する実行基盤、ローカルデモ、ベンチマークの実行方法がまとめられています。 コードはApache License 2.0で提供されていますが、同梱される第三者コード、ベンチマーク、データセットには個別の利用条件があります。
プロンプト・コンテキスト改善より
作業規則の追加は、プロンプト改善と同じように見えるかもしれません。 しかし、プロンプト改善が主に指示の方法を扱い、コンテキスト改善がAIに渡す情報を扱うのに対し、ハーネス改善はAIが使う作業手順、道具、確認箇所まで対象に含めます。
| 改善対象 | 主な問い | 変更例 |
|---|---|---|
| プロンプト | 何をどう依頼するか | 役割、出力形式、禁止事項 |
| コンテキスト | 判断に必要な情報は何か | 社内規程、顧客履歴、過去事例 |
| ハーネス | どの手順と道具で完了させるか | 検索、計算、分担、保存、検査 |
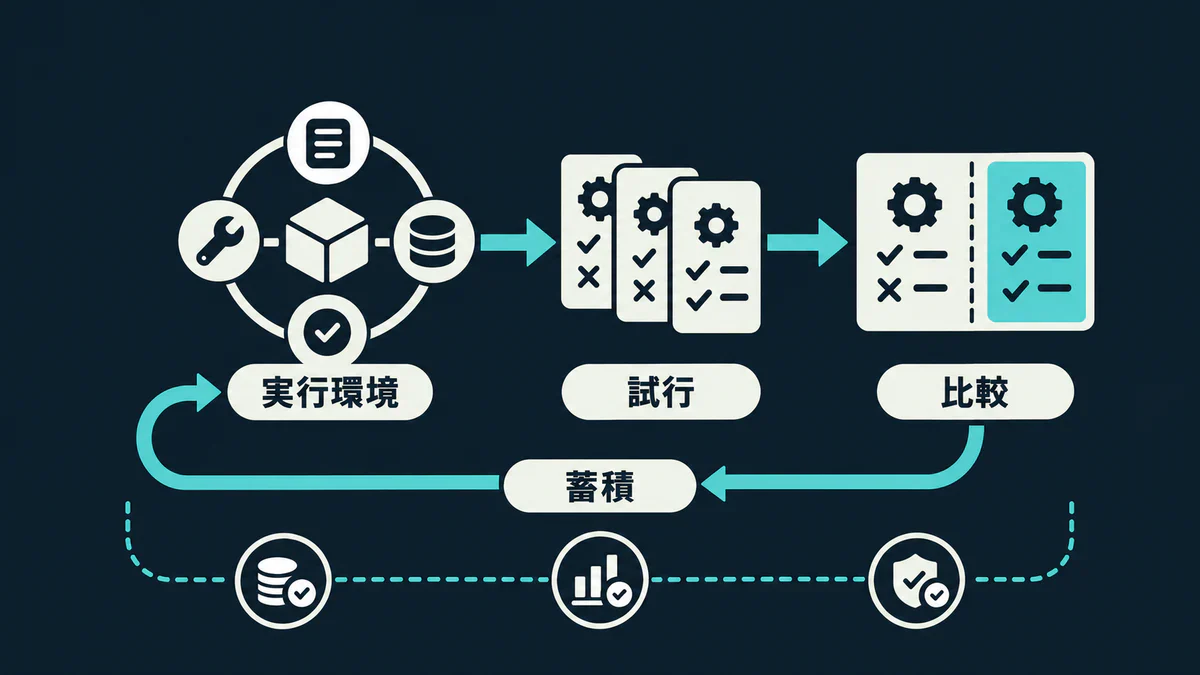
Harness²は、これらの改善対象を共通の試行手順で比較します。 タスク単位の改善は、Propose、Probe、Composeの順に進みます。 改善案を作り、同じ仕事で挙動を試した後、変更前後の差を基に採用案を合成します。
正解データがない仕事でも、担当者は実行過程の差を比較材料にできます。 ただし、実行過程の比較だけで、成果物の正しさを保証できるわけではありません。
Harness²は、採用したハーネスと根拠のある学びを蓄積し、後の仕事の改善に利用します。 研究チームは、この仕組みをタスク単位とハーネシング単位からなる二層の再帰と説明しています。 詳しい定義と評価条件はHarness²の原論文↗で確認できます。
事業上の
Harness²を使うと、担当者は改善案を比較し、採用結果を残す工程を再利用できます。 一度だけ良い回答が得られても、業務が変わるたびに担当者の判断で指示を書き直していては、同じ方法で改善を続けられないためです。 失敗、変更、再試行の記録も、次の判断材料になります。
想定される効果は対象業務によって異なります。
- 時間:再調査や転記確認など、成果物の修正にかかる時間を減らせる可能性がある
- 品質:確認手順や専門業務のスキルをハーネスに含め、同じ抜けの再発を抑える
- 意思決定:モデル名だけで選ばず、自社の評価指標を満たした構成を比較する
- リスク低減:道具の使用範囲、参照先、最終承認を変更可能な規則として管理する
原論文では、研究チームが3種類の業務ベンチマークと、モデルとハーネスを組み合わせた4つの構成を評価し、1回の改善後に基準構成を上回ったと報告しています。 最大の改善幅は、WorkBuddy-Benchで11.5ポイント、JobBenchで4.5ポイント、法律業務を扱うLABの部分合格率で11.8ポイントでした。 Harness²の評価結果と条件↗
ただし、これらは特定のベンチマークで得られた数値です。 自社の売上増加、工数削減、事故減少を予測する数値としては使えません。 事業責任者は、自社の業務指標で効果を測り直す必要があります。
検証には
Harness²の検証に向くのは、成果物を繰り返し作成でき、担当者が良し悪しを比較できる知識業務です。 候補となる業務は、次の条件で絞れます。
- 同種の依頼が繰り返し発生する
- 正確さ、所要時間、修正量などで成果物を評価できる
- 試行用データを用意できる
- AIの出力を人が確認してから利用できる
- 失敗した場合に元の手順へ戻せる
具体例には、社内問い合わせの回答案、複数資料からの報告書作成、顧客メールの下書きがあります。 いずれも同種の依頼が繰り返され、人が成果物を確認してから利用する業務です。
一方、一度の誤りが重大な損失につながる処理や、担当者が結果を評価できない業務を、最初から自動化する用途には向きません。 請求確定、採用判断、法的見解の確定のように人が責任を負う業務では、Harness²を使っても最終承認を人が行います。
小規模検証では
導入の可否は、改善幅だけでは決められません。 試行を増やすほど比較材料は増えますが、実行費用と管理負担も増えるためです。
最初の検証では、対象を一つの業務と少数の過去案件に限定します。 そのうえで、現在の方法と改善後の方法を同じ指標で比較します。
- 対象業務を一つ選び、入力、成果物、人が承認する箇所を明記する
- 正確さ、修正時間、再利用率などから二つ程度の評価指標を決める
- 現在のハーネスで基準値を測る
- 1回の改善を試し、同じ条件で再評価する
- 費用、処理時間、情報漏えいの可能性、誤りの種類を比較する
- 採用、追加検証、中止の基準に照らして判断する
本番導入は、品質の上昇分が追加の実行費用と管理負担に見合う場合に限ります。 品質が上がっても、費用や処理時間が許容範囲を超える場合は採用できません。
試行方法によっても費用は変わります。 公式のローカルデモはモデルの認証情報なしで動かせますが、モデルを使うベンチマークを実行するとAPI費用が発生します。
公式のHarness²実験ガイド↗によると、並列方式では複数の候補を広く試し、逐次方式では前の改善を引き継いで試行を重ねます。 どちらの方式でも、試行予算を増やせば実行回数が増えます。
費用に加えて、評価用データの管理も必要です。 同ガイドでは、AIが評価用の公開データを参照する可能性があるため、ネットワークを制限するよう求めています。 社内検証でも、正解や評価基準を実行側から見えない場所に置かなければなりません。 AIの実力が変わっていなくても、評価情報を参照すれば点数だけが上がるおそれがあるためです。
外部の事業者と技術検証を進める場合も、発注側が業務指標と中止条件を決めます。 株式会社atypicalのAIエージェント開発とPoCの進め方では、現在の使い方と試作を同じ業務で比べる考え方を紹介しています。
まとめ
Harness²とは、AIモデルを入れ替えず、指示、道具、記憶、確認手順を試行結果に基づいて改善する研究用フレームワークです。 成果物の抜けや確認漏れが起きたとき、担当者は作業規則や確認方法を変更し、結果を比較できます。
Harness²は、正解データがない業務でも改善案を作れます。 ただし、ベンチマークの改善幅を自社の事業効果にそのまま置き換えることはできません。
導入前には、比較できる反復業務があるかを確認し、評価指標、追加費用、情報管理の条件を決めます。 条件を満たす企業は、一つの業務に限定した小規模検証から始められます。 条件を満たさない企業は、成果物の評価基準と人が承認する箇所を先に整理します。