AI
Claude Code トークン削減方法|Spotify事例と導入判断
Claude Code トークン削減の方法を、Spotifyの検証事例を基に解説します。大規模ファイルの読み取りを別処理へ振り分ける仕組み、平均90%削減という結果の条件、任せやすい作業と対象外の作業、品質や人件費を含めた導入効果の測り方をまとめました。
はじめに
Claude Code トークン削減では、セッションを仕事ごとに分け、読む範囲を指定し、不要な連携を外すところから始めます。 大規模ファイルの読み込みが消費の多くを占める場合は、判断や編集を担うモデルに全ファイルを直接読ませない方法もあります。
目的の箇所を探すたびに多数のファイルを読み込むと、Claude Codeはその内容を後続の応答でも処理します。 不要な読み込みが一度あるだけでも、長い作業ではトークン消費が増えます。
Spotifyは、大規模ファイルの読み込みに使うトークンを平均90%削減したと報告しています。 ただし、この削減率をほかの開発業務へそのまま当てはめることはできません。
この方法を導入しやすいのは、読み取りや定型生成を安全に切り分けられる開発組織です。 事業責任者は、回答品質、処理時間、運用負荷、機密情報の扱いを確認し、削減後の総費用で導入を判断します。
Claude Code トークン削減は消費の内訳から始める
Claude Code トークン消費の原因は、利用料の総額だけでは特定できません。 会話の長さに加えて、ファイルの内容、ツールの実行結果、過去の応答も処理対象になるためです。
同じセッションで無関係な仕事を続けたり、大きなファイルを丸ごと読ませたりすると、その後の処理対象も増えたままになります。
Anthropicは、トークン費用が処理対象となる情報量に応じて増えると説明しています。
Claude Codeのコスト管理ガイド↗では、不要になった作業の区切りで /clear を使う方法や、用途に合ったモデルの選び方を案内しています。
同ガイドでは、フックやスキルへ前処理を移す方法に加え、/usage でセッション単位の使用量を確認する方法も紹介しています。
事業責任者が先に確認すべきなのは、総額よりも消費の内訳です。 消費の要因によって、試す対策が異なります。
| 消費の要因 | まず試せる対策 | 期待できる変化 |
|---|---|---|
| 無関係な作業履歴 | 仕事の切り替わりでセッションを分ける | 古い情報の再処理を減らす |
| 大規模ファイルの探索 | 範囲を指定して読む | 入力トークンを抑える |
| 単純な調査や要約 | 軽量モデルや別処理へ委ねる | 高性能モデルを重要な判断へ回す |
| 過剰なツール定義 | 使用しない連携を外す | 毎回渡す情報を減らす |
小規模な利用では、セッションの整理と対象範囲の指定だけでも改善する余地があります。 それでも大規模ファイルの読み込みが消費の多くを占める場合は、別モデルへの振り分けを検討します。
平均90%削減は大規模ファイルの読み取りが対象
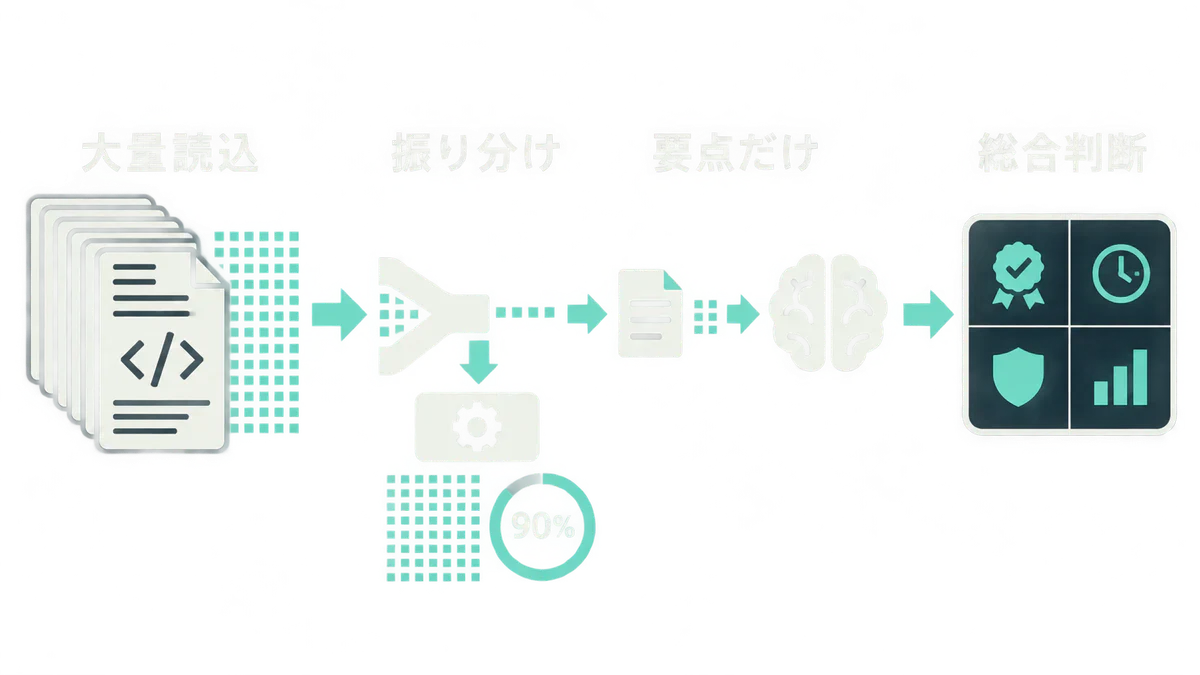
Spotifyは、大規模ファイルをClaudeへ直接読ませず、質問への回答だけを返す方法を採りました。 公開プラグイン「shunt」は、Claude Codeが大規模ファイルを直接読む前に処理を止め、読み取り専用の別モードへ渡します。
判断や編集を担うClaudeが受け取るのは、ファイル全体ではなく質問への回答です。 渡す情報を限定することで、Claudeが処理する情報量を抑えます。
処理の流れは次のとおりです。
- フックがファイル全体の読み込みを検知する
- 規定行数を超える場合、専用スクリプトへ処理を振り分ける
- 別モードがファイルを読み、質問に必要な結果だけをClaudeへ返す
Spotifyの公式READMEによると、初期設定では350行を超えるファイルが振り分けの対象です。 行番号や範囲を指定した読み込みと、小さなファイルは、通常どおりClaudeが処理します。
検証の詳細、導入条件、対象外の作業は公式READMEで確認できます。
同READMEには、162,000行のJavaモノレポを使った検証結果が掲載されています。 4,014行の単一ファイルでは、33,684トークンが5,737トークンへ減少しました。 ソースとテストを組み合わせた7,408行の処理では、75,990トークンが4,148トークンへ減っています。 複数の一括読み込みにおける平均削減率は90%でした。
ただし、この90%は、大規模ファイルを読み、質問に答える検証で得られた削減率です。 設計、デバッグ、編集を含む開発業務全体や、製品全体の利用料が90%減るという結果ではありません。
軽量モデルへ振り分けやすい作業
軽量モデルへ任せやすいのは、入力と期待する出力を限定でき、担当者が結果を機械的または短時間で確認できる作業です。 読み込みを分けても、すべての作業で費用が下がるとは限りません。
複数の事情から結論を出す作業や、原文どおりの編集が必要な作業は、判断や編集を担うモデルに残します。
| 任せやすい作業 | 任せにくい作業 |
|---|---|
| 大規模ファイルから指定情報を探す | 障害原因を推論するデバッグ |
| 複数ファイルの概要を作る | システム構成を決める |
| 既存例に沿った定型コードを生成する | 既存コードを正確に編集する |
| 名前や依存関係を一覧化する | 要件の曖昧さを解消する |
Spotifyのshuntも、デバッグ、編集、小さなファイル、設計判断を委譲対象から外しています。 定型コードの生成では参照ファイルを必須とし、既存の命名や書き方から外れにくくしています。
別モデルを使えば、単価を抑えられる可能性があります。 高性能モデルへ渡す情報を判断に必要なものへ絞ると、利用上限への到達を遅らせ、長い開発作業が中断するリスクも減らせる可能性があります。
ただし、別モデルの出力確認に時間がかかれば、トークンの削減額を人件費が上回る場合があります。
導入前の確認項目
導入前には、削減率、品質、処理時間、安全性、保守負担を同じ検証で確かめます。 トークン数だけで判断すると、誤った要約や待ち時間の増加を見落とすためです。
Anthropicの公式文書では、利用状況、予算、認証を一元管理する仕組みをLLMゲートウェイと呼んでいます。 管理を一元化できる一方、運用担当者はClaude Codeの更新に合わせて互換性を保たなければなりません。
Claude CodeのLLMゲートウェイ解説↗も踏まえ、比較を始める前に次の条件を決めます。
- どの種類のファイルを外部の処理先へ送るか
- ソースコードや顧客情報を処理先へ送信できるか
- 誤った要約を誰がどの方法で検出するか
- Claude Codeやプラグインの更新を誰が追うか
- 障害時に通常の処理へ戻せるか
最初の二項目では、外部へ送れる情報の範囲を決めます。 残る項目では、誤った要約を検出する方法と担当者、更新対応や障害対応の担当者を明確にします。
Spotifyのshuntには、入力をコマンドライン引数として渡すことによるサイズ上限があります。 一回の呼び出しに対する既定のタイムアウトは180秒です。
公開事例を自社の導入手順としてそのまま使うことはできません。 担当者は、自社のコード量、端末環境、情報管理規程に照らして導入の可否を判断します。
削減効果は総費用で測る
削減効果は、同じ作業を振り分けの前後で実行して測ります。 比較する項目は、入力トークン、完了時間、回答の正確さ、修正時間です。
一度の成功例だけでは、月間費用への影響を判断できません。 実際に頻度の高い作業を複数回測る必要があります。
変更による影響を分けるため、検証は次の順序で進めます。
- 直近の業務から、大規模ファイルの調査を含む代表的な作業を3〜5件選ぶ
- 現在の方法でトークン使用量、所要時間、手直し回数を記録する
- 読み取り処理だけを別モデルへ振り分け、同じ条件で再実行する
- 開発者が回答の欠落や誤りを確認する
- 削減額から確認作業と運用保守の人件費を差し引く
判断表には、少なくとも次の指標を残します。
| 指標 | 確認したいこと |
|---|---|
| 入力トークン | 処理する情報を実際に減らせたか |
| 完了時間 | 外部処理によって待ち時間が増えていないか |
| 正答率または合格率 | 必要な情報が欠けていないか |
| 手直し時間 | 開発者の確認負担が増えていないか |
| 対象作業の発生頻度 | 改善が月間費用へ十分に効くか |
| 保守時間 | 更新対応を含めても採算が合うか |
入力トークンが減っても、増加した完了時間や手直し時間まで削減効果に含めることはできません。 対象作業の発生頻度と保守時間も含めて採算を比較します。
API利用ではClaude Consoleの請求データを基準にし、Claude Codeの /usage は作業別の比較に使います。
サブスクリプション契約では、表示されるセッション費用が実際の請求額を意味しない場合があります。
そのため、プランの利用上限と、作業を継続できるかどうかも評価します。
まとめ
Claude Code トークン削減では、セッションを仕事ごとに分け、読む範囲を指定し、不要な連携を外す方法から試します。 それでも大規模ファイルの一括読み込みが消費の多くを占める組織では、Spotifyのshuntのように、読み取りや定型生成を別処理へ振り分ける方法が候補になります。
Spotifyが報告した90%は、特定の読み込み処理を対象にした検証結果です。 開発業務全体のトークンを90%削減できるという意味ではないため、そのまま導入判断には使えません。
事業責任者は、削減後も品質と所要時間を保ち、確認と保守を含む総費用が下がるかどうかを確認します。 まず、大規模ファイルの読み込みが現在の消費に占める割合を調べ、代表的な作業を少数選んで現状値を測ります。 読み込みの割合が小さい場合は、先にセッションの整理を試します。