AI
AutoScientist-Quantとは?
AutoScientist-Quantが仮説生成、アルファ探索、候補選別、予測モデル選択をどう進めるのかを解説します。AIクオンツの事業価値、先読みバイアスを避ける評価方法、実運用との差、導入前に決める検証指標と停止条件を非専門家向けに整理します。
はじめに
クオンツリサーチでは、試す仮説を増やすほど、有望な指標を見つける機会も増えます。 しかし、試行が増えれば、担当者が偶然成績のよかった候補を選ぶ危険も高まります。 そのため、試行回数だけでは投資研究の質を判断できません。
この研究工程を自動化する仕組みが、AutoScientist-Quantです。 AutoScientist-Quantは、市場データを基に投資仮説を立て、検証し、有望な指標と予測モデルを選ぶまでを扱う研究フレームワークです。 AIは仮説生成に加えて、コード作成、バックテスト、候補の比較、似た指標の整理、モデル選択を繰り返します。
ただし、自動化の対象は研究工程です。 AIに投資判断を任せられるわけではありません。 経営者や事業責任者は、未知の期間でも結果を再現できるか、実際の取引条件を反映しているか、人が損失を管理して承認できるかを確認します。 導入時には、限られた調査予算で再現可能な探索を続けられるかまで評価します。
AutoScientist-Quantが
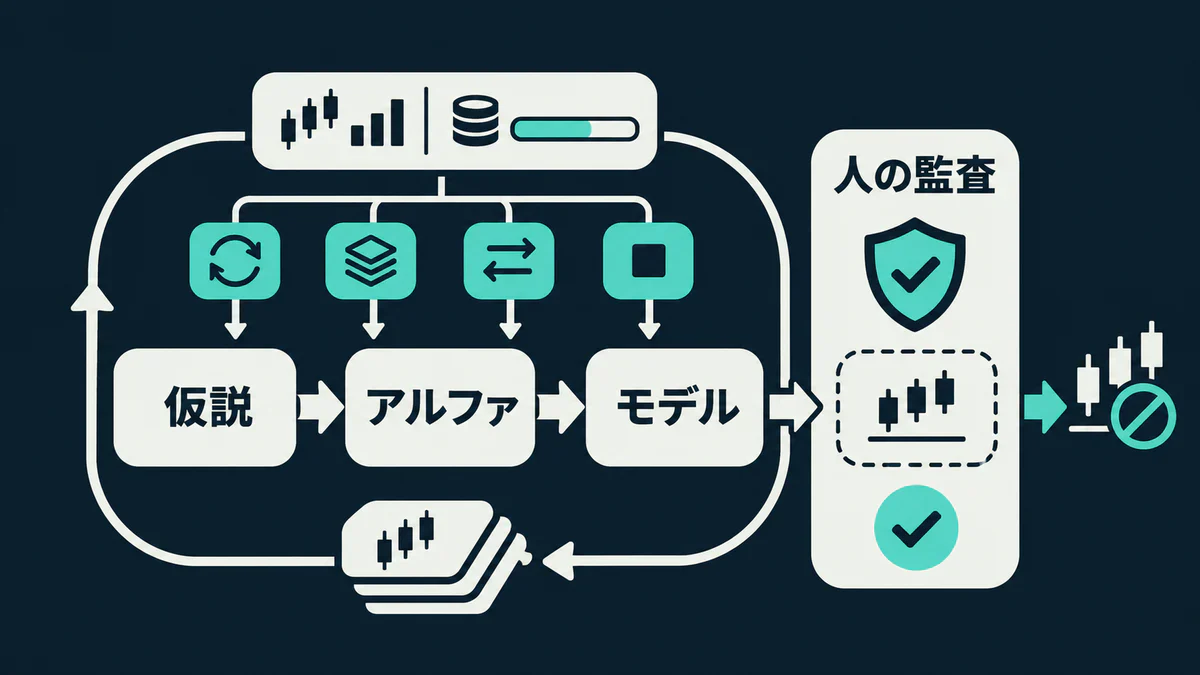
AutoScientist-Quantは、投資仮説の生成、指標の探索、候補群の選別、予測モデルの選択を一つの工程として扱います。 研究担当者が個別に繰り返してきた実験を、共通の判断機構で進める仕組みです。
AIは価格や出来高などの履歴を使い、将来の値動きとの関係を検証する銘柄評価指標を作ります。 この指標をアルファと呼びます。 論文では、処理を次の三段階に分けています。
- 市場に関する仮説を立て、アルファをコードにしてバックテストする
- 得られたアルファから、重複が少なく有用な組み合わせを選ぶ
- 選んだ指標を使う予測モデルと、その設定を比較する
各実験では、AIが仮説の検討、実装、デバッグ、学習、バックテスト、振り返りを繰り返します。 AutoScientist-Quantの原論文↗によると、AIは探索履歴を共有し、過去の成功や失敗を後の試行に利用します。
ただし、この工程で得られるのは、研究段階で検証した候補です。 売買に使うには、担当者が注文執行、流動性、法令や社内規程への適合、急変時の停止方法を別途決める必要があります。
AIクオンツとの
AutoScientist-Quantの特徴は、残りの予算と途中結果に応じて探索方針を変える点にあります。 決められた工程を固定回数だけ繰り返す方法では、前提が誤っていても同じ方向の実験を続けます。 一方、AutoScientist-Quantは見込みの薄い試行を止め、成績のよい候補に計算資源を振り分けます。
各ラウンドで選ぶ行動は、次の四つです。
| 行動 | 何をするか | 業務上の意味 |
|---|---|---|
| Improve | 既存候補の弱い部分を修正する | 有望な案を残して改善する |
| Combine | 複数候補の要素を組み合わせる | 別々の実験で得た知見を再利用する |
| Pivot | 新しい仮説へ方向転換する | 成果の出ない探索への固執を避ける |
| Stop | 改善余地が小さい探索を止める | 予算を別の候補へ残す |
Improveでは既存候補を修正し、Combineでは複数の実験で得た要素を組み合わせます。 成果を見込めない場合、AIはPivotで仮説を変えるか、Stopで探索を終えます。 AutoScientist-Quantは、この予算配分まで自動化します。
Google Researchの研究紹介↗によると、AIは同じ判断機構をアルファ探索、候補の絞り込み、モデル調整に使います。 担当者は探索履歴を確認することで、結果に至るまでの判断を追跡できます。
クオンツリサーチの
AutoScientist-Quantを導入しても、利益率が保証されるわけではありません。 AIが担うのは、研究者が試せる仮説を増やし、比較と記録にかかる作業を減らすことです。 研究者は、探索条件の設定、結果の検証、候補の採否、リスク管理を担当します。
事業責任者は、次の指標を使って現在の研究工程と比較できます。
- 一つの有効候補を得るまでに要した人員、計算費用、日数
- 生成されたコードのうち、修正せず実行できた割合
- 未知の期間や別市場でも基準を満たした候補の割合
- 人が却下した候補と、その理由を追跡できる割合
- 実験を再実行して同じ結果を得られた割合
生成した候補の数だけでは、自動化の効果を判断できません。 費用、再現性、監査可能性も比較します。
論文では、著者らが2015年1月から2026年5月までのデータを四期間に分け、中国と米国の計六つの銘柄群(株式ユニバース)で検証しています。 著者らは、比較対象に対して多くの評価項目で優位だったと報告しました。 ただし、この結果は論文で指定したデータ、取引ルール、費用条件に基づきます。 原論文の実験設計と結果↗から、将来の収益を予測することはできません。
投資研究以外でAIエージェントを評価する場合も、担当者は現在の手順と試作品を同じ指標で比較します。 atypicalのAIエージェント開発サービスでも、この進め方を紹介しています。
バックテストでは
バックテストでは、未知の期間を探索から隔離します。 未知の期間で好成績を収めても、担当者やAIがその期間の情報を候補選びに使っていれば、再現性の根拠にはなりません。 探索用の期間と最終評価用の期間を分け、最終評価の結果を見ずに候補を選びます。 担当者は、データの時点とコードも監査します。
この監査で確認する問題の一つが、先読みバイアスです。 先読みバイアスとは、将来公表される数値を過去の売買判断に使うことを指します。 たとえば、決算期末には未公表だった財務情報を、その時点で利用できたものとして計算すると、実際の取引では再現できない成績が出ます。 QuantConnectの先読みバイアス解説↗でも、意思決定時点で利用可能だったデータを使うよう求めています。
AutoScientist-Quantの実験では、データを次の四期間に分けています。
| 期間 | 用途 | AIの探索に見せるか |
|---|---|---|
| 学習期間 | 予測モデルを学習する | 見せる |
| 検証期間 | モデル調整や早期終了に使う | 見せる |
| フィードバック期間 | 仮説と候補を比較する | 見せる |
| テスト期間 | 最後の成績だけを測る | 見せない |
AIは、学習、検証、フィードバックの各期間を探索に使います。 一方、テスト期間は、担当者が最後の成績を測るまでAIに見せません。 論文の著者らは、過去の評価処理にあった二つの先読み問題を修正したうえで、このように期間を分離しています。
ただし、期間を分けただけでバックテストの信頼性が確定するわけではありません。 担当者は、銘柄の入れ替え、後日修正されたデータ、売買可能な価格、手数料、値動きに対する注文量、モデルが学習済みの情報を確認します。 時系列を分割しても、当時使えなかった情報が混ざれば、先読みバイアスは残ります。 探索に使わない情報が学習や候補選びへ漏れる問題を、データリークと呼びます。
導入前に
導入担当者は検証を始める前に、評価期間、利用可能なデータ、費用上限、停止条件、人が承認する範囲を決めます。 収益目標だけでは、AutoScientist-Quantを導入できるか判断できません。
条件を固定した小規模な検証では、自動化による効果と評価上の錯覚を分けて確認できます。 検証計画には、少なくとも次の項目が必要です。
- 対象市場、投資期間、利用できるデータを定める
- 学習、検証、探索用フィードバック、最終テストの期間を固定する
- 取引費用、注文可能量、売買タイミングを現実の条件に合わせる
- 計算費用と試行回数の上限を設ける
- 未知の期間で満たすべき成績と損失の基準を決める
- コード、データ、採用理由を人が監査できる状態にする
- 継続、修正、中止を決める責任者を明確にする
対象と期間を固定すれば、担当者は候補を同じ条件で比較できます。 取引条件を現実に合わせなければ、バックテストの成績と実運用の結果は離れます。 費用上限と停止条件を設けない場合は、成果を確認する前に試行回数が増えるおそれがあります。 最後に、責任者がコード、データ、採用理由を監査し、継続や中止を判断します。
AutoScientist-Quantの導入には、時系列データ、繰り返し使える評価方法、実験を監査する専門家が必要です。 データの来歴が分からず、成功条件が曖昧で、生成コードを確認できない組織では、候補を増やすほど誤った選択の危険が高まります。 したがって、導入できる範囲は組織が検証できる範囲までです。
まとめ
AutoScientist-Quantは、仮説生成からアルファの選別、予測モデルの選択までを扱う研究フレームワークです。 AIは予算と途中結果に応じて、候補の改善、組み合わせ、方向転換、停止を選びます。 企業は探索範囲を広げ、研究者の作業時間を減らし、実験中の判断を記録できますが、投資成果は保証されません。
投資研究の質を保つには、試行回数を増やすだけでは不十分です。 担当者は未知の期間を探索から隔離し、当時利用できたデータだけを使い、実際の取引条件を再現します。 そのうえで、人が結果とコードを監査します。
導入可否をバックテストの成績だけで決めるのは危険です。 限定した市場と業務範囲で評価方法を先に決めるか、既存の研究工程を計測して自動化する部分を選びます。 どちらの場合も、担当者が最初に固定するのは評価条件です。