AI
AIエージェント ポストトレーニングの
AIエージェント ポストトレーニングについて、SFT、蒸留、強化学習、RL環境、ハーネスを使う学習の違いを整理します。非技術系の事業責任者が、対象業務や評価基準、費用対効果から追加学習の要否と開始地点を判断できるよう、プロンプト改善を優先すべき条件も解説します。
はじめに
既製のAIエージェントは、同じ指示を与えても成功と失敗を繰り返すことがあります。 追加学習によって動作を安定させられるかどうかは、業務と失敗の性質によって異なります。
既存モデルに、自社業務で求める行動を追加で学ばせる工程が、AIエージェント ポストトレーニングです。 問い合わせ対応や書類処理など、繰り返し発生し、担当者が成否を測れる業務に向いています。
ただし、すぐに追加学習を始めるべきではありません。 まず、担当者がプロンプトや業務フローを修正しても、同じ失敗が残るかを確かめます。 失敗の原因を特定できなければ、教師データと採点基準を作れず、費用を投じた後も改善の有無を判断できません。
AIエージェント ポストトレーニングは
AIエージェント ポストトレーニングの対象は、モデルが出す最終回答だけではありません。 開発担当者は、望ましい回答、評価結果、実際の操作結果をモデルへ与え、必要な行動を取りやすくします。
この工程では、モデルを一から作りません。 事前学習済みの知識を残しながら、モデルを特定の業務に合わせます。
PyTorchの解説では、LLM ポストトレーニングを、人が望む回答や推論の仕方をモデルに教える工程と説明しています。 その方法の一つである教師ありファインチューニング(SFT)は、模範回答を単語単位で模倣させます。 作成したデータの品質が性能の上限を左右します(PyTorchのLLMポストトレーニング入門↗)。
AIエージェントは最終回答に至るまで、検索し、システムを操作し、結果を確認します。 そのため、担当者は、回答形式、途中の判断、失敗後の立て直しのうち、どこを直すのかを決める必要があります。 改善対象によって、選ぶ学習方法が変わるためです。
失敗の
Hugging Faceは、エージェント向けポストトレーニングを5つに整理しています。 それぞれに必要な学習材料も示しています(Hugging Faceのエージェント学習カリキュラム↗)。
| 方法 | 学習材料 | 向いている課題 | 主な注意点 |
|---|---|---|---|
| SFT | 良い作業例と回答例 | 書式、手順、ツールの呼び出し方を覚えさせる | 例にない失敗からの復旧は学びにくい |
| 蒸留 | 高性能な教師モデルの出力 | 高価なモデルの振る舞いを小さなモデルへ移す | 教師モデルの能力と誤りを引き継ぐ |
| 強化学習 | 試行結果に対する点数 | 正解を例示しにくいが、成功を採点できる仕事 | 多数の試行と信頼できる採点が要る |
| RL環境 | 状態を保つ業務環境と結果 | 複数手順をまたぐ操作や失敗からの復旧 | 検証用の安全な環境を作る必要がある |
| ハーネスを使う学習 | 実運用と同じ実行基盤での一連の作業 | ツールや制約を含む現場での再現性 | 運用基盤、監視、計算資源の負担が大きい |
5つすべてに取り組む必要はありません。 担当者は、直したい失敗に合う方法を選びます。
書式や決まった手順を覚えさせる場合は、良い作業例を使う「SFT」が候補です。 模範を示しにくくても結果を採点できる仕事なら、強化学習を検討できます。 複数の手順にまたがる操作で、途中の状態や失敗後の復旧まで扱う場合は、RL環境が必要です。
モデルへ指示を渡し、ツールの実行結果を受け取って次の行動へ進める実行基盤を、エージェントハーネスと呼びます。 実運用と同じハーネスを使えば、本番に近い条件で学習できます。 一方で、モデル、ツール、実行基盤のどこに失敗の原因があるのかを、担当者が切り分けにくくなります。
成功率と
学習方法を選んでも、費用に見合うとは限りません。 事業責任者は、反復業務の成功率と、担当者が修正や再実行に費やす時間を測ります。 処理件数が多く、1件ごとの成否を記録できる業務ほど、投資前後を比較しやすくなります。
たとえば、受注メールの内容を基幹システムへ登録するエージェントでは、文章の自然さを評価しても投資判断には使えません。 担当者が確認するのは、必須項目の取得率、誤登録率、人による差し戻し率、処理時間です。 これらの数値が改善すれば、担当者は転記作業を減らし、例外処理へ時間を回せます。 顧客が回答を待つ時間も短くできる可能性があります。
高性能な教師モデルの業務行動を小さなモデルへ移す方法が、蒸留です。 「蒸留」には、推論費用や応答時間を抑えられる余地があります。 ただし、事業責任者は利用量だけでなく、教師データの作成費、学習基盤、再評価の頻度も含めて費用対効果を計算します。 学習費だけを比べると、運用後の監視費と更新費が計算から抜けます。
強化学習を選べるのは、担当者が成功を自動判定できる業務です。 Metaの公式文書は、望ましい回答例がある場合にSFTを使うと説明しています。 完全な模範を示しにくくても、成功を自動確認できる場合は強化学習を使います(Metaのポストトレーニング公式ガイド↗)。
一方、採点基準が曖昧なまま試行回数を増やしても、安定した改善は見込めません。 人や別のAIが一貫しない基準で採点すれば、評価も揺れます。 AIエージェントが、業務上の目的より採点基準を優先する問題にも注意が必要です。
追加学習の
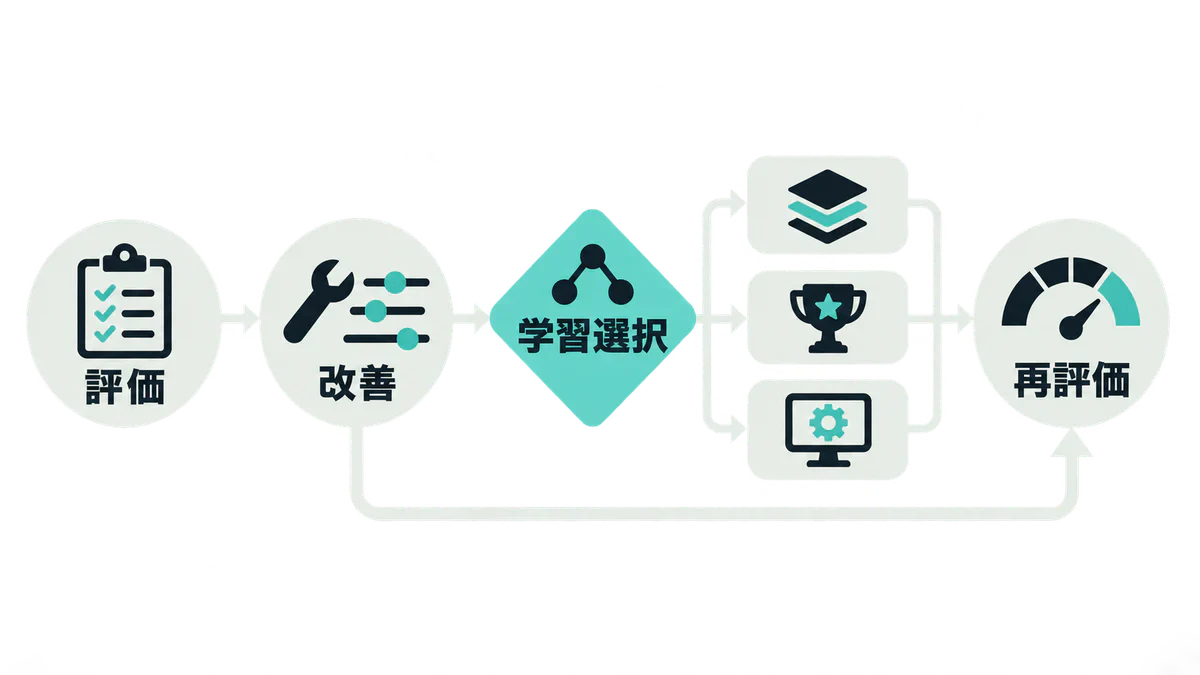
導入前に決めるのは、対象業務と合格条件です。 次に、現行のAIエージェントと追加学習後の結果を比べる基準を決めます。 その基準で失敗条件を測ってから、追加学習の範囲を定めます。
判断は次の順で進めます。
- 対象業務を一つに絞り、入力、操作、成果物、人が確認する箇所を書き出す
- 実際の案件から評価用の課題を作り、成功率、差し戻し率、処理時間などを測る
- 指示文、参照情報、ツール、業務フローを修正して再評価する
- 残った失敗を分類し、模範例で直せるならSFT、結果を自動採点できるなら強化学習を候補にする
- 未使用の評価課題で再測定し、品質向上と運用費を比較する
評価用データを学習にも使うと、担当者は未知の案件に対する改善を測れません。 そのため、学習用データと最終評価用データは分けて管理します。 AIエージェントの評価方法を先に整えたい場合は、サイト内のHarborを使ったAIエージェント評価の解説も判断材料になります。
着手を見送る条件も、導入前に決めておきます。 対象業務が頻繁に変わる場合、成功を定義できない場合、十分な事例を集められない場合は、学習より先に業務を整理し、小規模に試します。 失敗時の損失が大きく、人による確認も置けない業務も、追加学習を始める段階ではありません。
まとめ
AIエージェント ポストトレーニングは、繰り返し発生し、担当者が成功を測れる業務に既存モデルを合わせる方法です。 模範例がある場合はSFT、高性能モデルの行動を移す場合は蒸留、結果を客観的に採点できる場合は強化学習が候補になります。 複数の手順や実運用のツールまで学習対象に含める段階で、RL環境やハーネスを検討します。
ただし、「同じ指示で結果が安定しない」という理由だけで、追加学習を始めるべきではありません。 まず、担当者が対象業務を一つ選び、現行手法の成功率と失敗例を記録します。 プロンプトや業務フローの修正で失敗が解消するなら、追加学習は不要です。 修正後も同じ失敗が残り、改善による価値を測れる場合に、必要な範囲が最も小さい手法から検証します。